
@strizhechenko @cauf Ну как бы то есть вот. Я к тому, что как можно учить некое «программирование» по абстрактным описаниям, когда для каждого языка есть свои фишки, принципиально различающиеся прям в самих основах?
Перефразирую: если я хочу таки въехать в Python — что мне даст описание низкоуровневых циклов, когда в нём всё объекты?

@erua Расписано, как всегда, шикарно, это да 🙂
Но я не совсем понял — чего конкретно «нету такого»?
Я как бы к тому, что вот эти все «условия и циклы» по идее изучаются в подростковом возрасте за неделю-другую. Тогда как «программирование» — это уже их конкретная реализация для языка и операционки, с учетом особенностей особенностей (sic!).
Разве не так? Спросить у сервера json с постами — 4 строчки; ебаться с красивой отрисовкой наших постов — пару месяцев работы и 100 мегабайт кода (утрирую, конечно).
@erua
> Но ведь они должны что-то и как-то делать — сами по себе без циклов и ветвлений, волшебных образом?
Вроде да. Сокрытие реализации, все дела. И только по тестам можно понять, что будет быстрее, меньше памяти сожрет и т.д. Разве нет?
Я как бы не спорю, что такие понятия как циклы, условия, рекурсию и прочее — надо понимать, но ведь это что-то совсем дефолтное из школьной программы либо совсем хардкорное, если речь об алгоритмах.
Но алгоритмы ботанить надо вроде уже после того, как все фишки конкретного языка усвоишь и будешь знать, как правильно выстрелить себе в ногу??
но при этом классические алгоритмы и структуры данных никак не зависят от языков программирования и парадигм с идиомами программирования.
да, есть специфика и своебразность алгоритмов и структур данных в функциональном программировании, но это пока отдельная сфера академическо-эксперементальной группы вещей. не имеющей прикладного назначения и профессионального использования в промышленных или массовых программных системах.
условно, во всех языках программирования сами по себе структуры данных одинаковые. уникальных структур данных у языков нет, равно как и нет каких-то уникальных алгоритмов. различаются только подходы к тому, как эти самые структуры данных или алгоритмы могут реализовываться средствами конкретного языка программирования.
потому что хеш-таблицы или двоичные деревья, очереди и стэки или списки — они везде одни и те же.
стандартные библиотеки разных языков могут предоставлять различные подвиды или типы этих стандартных структур данных, но разработка софта редко ограничивается использованием лишь стандартной библиотеки языка. и если в ней нет какого-то вида бинарных деревьев или какого-то типа хеш-таблиц, то это не значит, что нет других библиотек реализующих эти виды/типы структур средствами данного языка.
когда человек учится программировать в плане разработки софта/программ, то обучение сводится именно к умению оперировать алгоритмами и структурами данных. а с помощью какого языка программирования человек выполняет эти действия — реализует алгоритм или делает структуру данных — это уже вопрос определяющийся всего лишь факторами доступности и уместности.
есть проблематика задачи и аспекты предметной области из которой она. характер решения задачи в плане алгоритмов и структур данных определяется требованиям с ограничениями. неразрывно связанными с проблематикой и применимостью решения задачи в предметной области.
одно дело подобрать алгоритм для сортировки трёх колод по 52 карты и совсем другое отсортировать номера телефона из справочника жёлтые страницы крупного города. и дело не в том, что сравнивать телефонные номера между собой проще, чем одинаковые игральные карты различающиеся лишь мастью. количество элементов подлежащих упорядочиванию различается на несколько порядков. это одна из лабораторных работ у студентов — посмотреть как от числа элементов зависит скорость работы того или иного алгоритма сортировки. что в случае 52×3 можно выбрать почти любой алгоритм, а для справочника телефонных номеров с сотнями тысяч записей — уже хорошо видна разница между подходами к упорядочиванию.
@erua Дык, телефоны-то в БД будут валяться, и маленький Бобби Пейджс кагбэ намекает, что вся «сортировка» там — это что-то типа SELECT че-те-надо? ;-)
P.S. Ну и тупо sorted() в зеленом змии, конечно?
понимание того, как асимптотическая сложность алгоритмов сказывается при росте объёма данных и влияет на впечатление пользователя от UX/UI — это полезно.
иначе говоря, тебя никто не агитирует разбираться в самих алгоритмах — ковыряться в них. от тебя требуется уметь использовать — уметь в многокритериальный анализ, осуществлять выбор.
@erua Ну так ведь зеленый змей умеет это в виде results = [t.age for t in mylist if t.person_id == 10], практически одно и то же (в плане того, что в одну строчку и вся магия под капотом)? И сложность можно измерить только тестами?
а на каких наборах? ну ведь у алгоритма с ожидаемым O(log n) бывают случаи, когда работает как O(n), а бывают и такие, когда O(n²) — так называемые худшие и лучшие.
у других алгоритмов стабильность другая, но в среднем они O(n×log n), зато нету худших случаев, т.е. не деградируют в зависимости от характера расположения чисел в сортируемом наборе (множестве).
это и есть то самое — знать за какое в среднем время работает алгоритм в зависимости от мощности множества (числа элементов в сортируемом наборе).
знать до какой скорости может деградировать в худшем случае. т.е. какова вероятность, что в некоторых случаях твой автомобиль успеет проехать два квартала, прежде чем отреагирует на команду включить что-либо.
@erua Ну епт. Я ж не погромист, в конце концов. Для меня логично — посчитать хеши для всех записей, типа неизбежная операция по чтению. Сравнивать хеши в зависимости от того, какя выборка нужна. Перепроверять по реальным данным найденное, чтобы не попасть на коллизии.
Но это как бы максимум, что я знаю про поиск по бд, даже если это CSV, который мы считали в структуру.
Если у меня 100500 15-мегабайтных файлов — это вроде хороший подход. Если 100500 номеров телефонов, которые надо бы привести изначально к стандартному формату — плохой.
Что будет делать Зеленый в случае, если я натравлю его на то или другое — я могу только догадываться.
ГДЕ мне тут поможет знание абстрактных алгоритмов, если я не в курсе, как он будет делать выборку??
@erua
О! Вот пример из реальной жизни. У меня есть каталог из 20 000 шрифтов. Названных черти как. Мне надо распарсить каждый, создать папочку с его названием (надо парсить файл), все варианты начертания — в одну папочку. Можно велосипедить на зеленом, можно штатными средствами венды на PowerShell. Сцуко, медленно и если ошибка, то хз, где и почему.
И знания, как писать алгоритнымы на ассемблере/в псевдокоде/на паскале тут вообще не помогут...
говорилось о том, что надо знать как выбирать алгоритмы и структуры данных для использования. причём не важно где расположенные — в стандартной библиотеке конкретного языка или в широко распространенных сторонних библиотеках.
а описанная тобой задача одноразовая и всем пофигу отработает она за пять минут или же за два часа, то и к программированию с разработкой софта это никаким боком не относится — это автоматизация задач системного администрирования.
есть:
Колисниченко Д. — «Командная строка Linux и автоматизация рутинных задач»
Агравал А. — «Автоматизация предприятия с помощью Python»
и т.д. и т.п.
@erua
> Там должна быть видна ссылка на какой из твоих «туутов» реагировал/отвечал.
У меня ветка предела достигла 😉
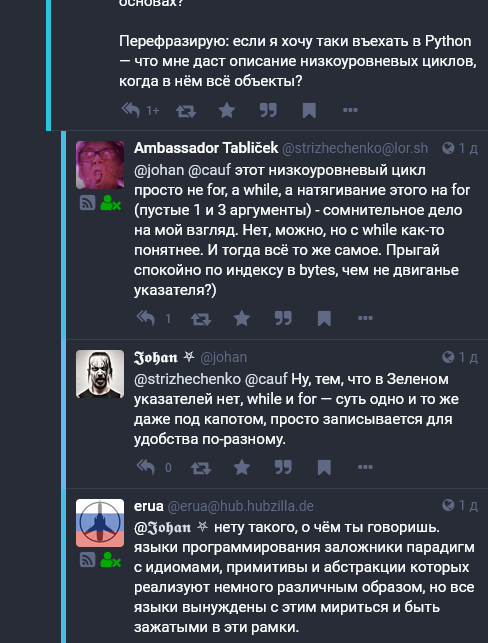

Там должна быть видна ссылка на какой из твоих «туутов» реагировал/отвечал.
Вот ты пишешь, что типа:
> как можно учить некое «программирование» по абстрактным описаниям, когда для каждого языка есть свои фишки, принципиально различающиеся прям в самих основах?
В каких таких основах отличающиеся? Вот про основы лежащие в каждом языке тебе и ответил.
> Перефразирую: если я хочу таки въехать в Python — что мне даст описание низкоуровневых циклов, когда в нём всё объекты?
А что эти объекты делают и для чего существуют? Утрировано, объекты — это экземпляры классов, а классы существуют нескольких типов (видов) используемых для различного назначения. Но ведь они должны что-то и как-то делать — сами по себе без циклов и ветвлений, волшебных образом?
Ну и т.д. и т.п.